AI, które nie pisze – tylko decyduje. Czy „semantyczny if” zmieni sposób, w jaki budujemy cyfrowe usługi?
Przez ostatnie lata przyzwyczailiśmy się, że sztuczna inteligencja pisze. Odpowiada na pytania, tworzy teksty, generuje kod, streszcza dokumenty, tłumaczy i prowadzi rozmowy. ChatGPT, Claude, Gemini i inne duże modele językowe sprawiły, że właśnie z generowaniem treści najczęściej kojarzymy współczesne AI.
Tymczasem coraz ważniejsze może okazać się zupełnie inne zastosowanie sztucznej inteligencji. AI, które niczego nie pisze. Zamiast tego po prostu podejmuje drobne decyzje:
“Czy ta wiadomość jest pilna?”
“Czy zgłoszenie powinno trafić do działu technicznego?”
“Którego narzędzia powinien teraz użyć agent AI?”
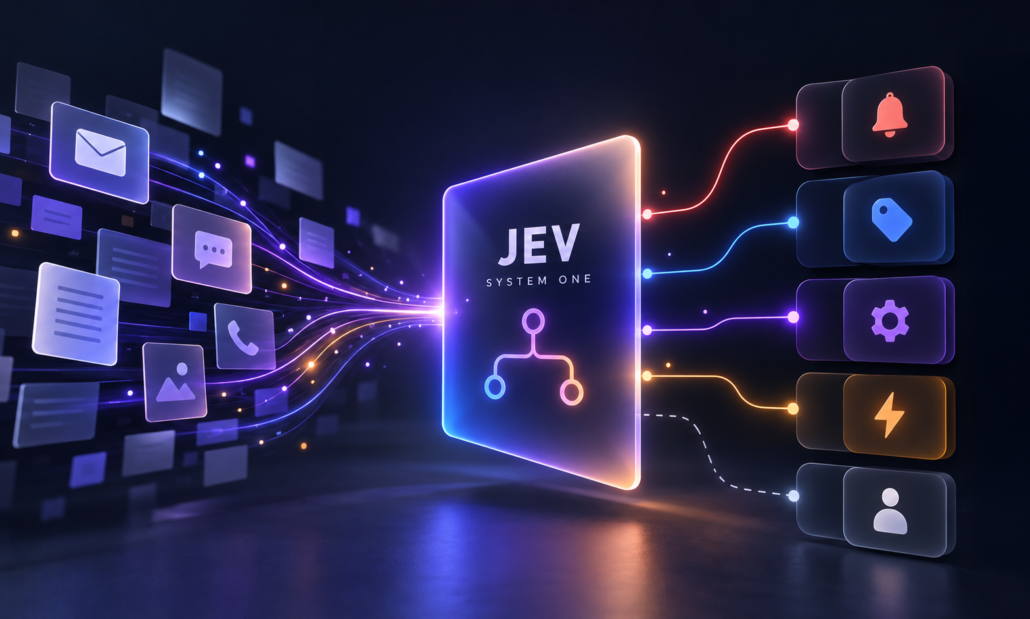
To właśnie na takie pytania ma odpowiadać Jev, nowy model firmy TypeSafe AI, określany jako pierwszy przedstawiciel kategorii System One Models. I choć sama nazwa brzmi dość technicznie, stojąca za nią idea jest zaskakująco prosta.
Po co prosić AI o esej, skoro potrzebujemy tylko „tak” albo „nie”?
Wyobraźmy sobie system obsługujący skrzynkę kontaktową firmy. Wpływa e-mail:
„Od rana nie możemy zalogować się do systemu. Za godzinę rozpoczynamy wysyłkę zamówień. Prosimy o pilną pomoc”.
Człowiek przeczyta tę wiadomość i niemal natychmiast stwierdzi: to jest pilne. Komputerowi jest trudniej. Klasyczny program świetnie radzi sobie z precyzyjnymi regułami:
jeżeli kwota > 10 000 zł → poproś o dodatkową autoryzację
Ale język naturalny nie jest tak uporządkowany. Klient nie musi przecież napisać słowa „PILNE”. Może powiedzieć „stoimy z produkcją”, „nie możemy wystawić faktur” albo „potrzebujemy tego przed spotkaniem o 12:00”. Tutaj świetnie sprawdzają się modele językowe. Pojawia się jednak problem: jeśli potrzebujemy tylko odpowiedzi tak lub nie, wykorzystywanie dużego modelu generatywnego może przypominać zatrudnianie copywritera do zaznaczania pól w formularzu.
Model dostaje wiadomość, następnie generuje odpowiedź, na przykład:
{
„urgent”: true
}
Program musi ją odebrać, sprawdzić, czy format JSON jest poprawny, odczytać wartość, obsłużyć ewentualny błąd i zdecydować, co zrobić dalej. A przecież od początku chodziło tylko o jedno: Czy wiadomość jest pilna?
I tutaj pojawia się „semantyczny if”
Każdy programista zna instrukcję if. Jeżeli spełniony jest warunek, program wykonuje określoną czynność:
jeżeli temperatura > 30°C
włącz klimatyzację
Problem zaczyna się wtedy, gdy warunku nie da się łatwo zapisać matematycznie. No bo w jaki sposób zaprogramować: jeżeli klient brzmi na zdenerwowanego albo jeżeli wiadomość prawdopodobnie dotyczy reklamacji…
Właśnie dlatego Jev bywa określany mianem „semantycznego if-a”. Zamiast sprawdzać tylko precyzyjne wartości, program może zadać modelowi pytanie dotyczące znaczenia i kontekstu informacji. Nie otrzymuje przy tym akapitu tekstu, lecz wynik, który może bezpośrednio wykorzystać.
Na przykład:
Prawdopodobieństwo, że e-mail jest pilny: 0,91
Programista może więc ustalić:
jeżeli prawdopodobieństwo > 0,8
wyślij powiadomienie
I nagle pomiędzy tradycyjnym kodem a dużym modelem językowym pojawia się coś nowego. Warstwa podejmowania małych, szybkich decyzji.
Jev nie napisze nawet jednego zdania
To jedna z najciekawszych cech tego rozwiązania. Jev nie został zaprojektowany do prowadzenia rozmów, pisania artykułów czy generowania kodu. Zamiast produkować kolejne słowa, analizuje przekazany kontekst i odpowiada za pomocą określonych wcześniej wartości.
Oficjalna dokumentacja TypeSafe wyróżnia trzy podstawowe rodzaje pytań: Noul, czyli ocenę prawdziwości w rodzaju „tak/nie”, Choice, czyli wybór spośród podanych możliwości, oraz Score, pozwalający ocenić coś według ustalonej skali. Co ciekawe, kilka takich pytań może być ocenianych równolegle względem tego samego zestawu danych.
W praktyce można więc zapytać system jednocześnie:
- czy klient jest zdenerwowany,
- czy wiadomość jest pilna,
- którego działu dotyczy problem,
- jak wysoki priorytet powinno otrzymać zgłoszenie.
I wykorzystać wyniki bez konieczności proszenia modelu o stworzenie rozbudowanej odpowiedzi.
Dlaczego to może być ważne?
Bo współczesne systemy AI zaczynają wykonywać coraz więcej czynności bez bezpośredniego udziału człowieka. Agent AI może dziś przeczytać wiadomość, wyszukać dokument, uruchomić narzędzie, pobrać dane z systemu, przygotować odpowiedź i zdecydować o kolejnym kroku. Każdy taki proces składa się z dziesiątek małych wyborów: “Co zrobić teraz?”
I tu zaczyna być widoczny problem ekonomiczny.
Jeśli do każdej drobnej decyzji uruchamiamy duży model generatywny, płacimy zarówno czasem, jak i zasobami obliczeniowymi. Według danych TypeSafe Jev ma kosztować 0,042 dolara za milion tokenów wejściowych, a odpowiedzi nie są dodatkowo rozliczane jak klasyczne tokeny wyjściowe. Producent podaje również czasy odpowiedzi rzędu 70-500 milisekund. Własne testy firmy pokazują bardzo duże różnice względem klasycznych LLM-ów, choć warto podkreślić, że są to benchmarki przygotowane przez twórców technologii i sami autorzy zaznaczają, że najlepsze wyniki pokazują górną granicę możliwych korzyści.
Ale nawet jeśli odłożymy marketingowe rekordy na bok, kierunek jest interesujący. Nie każda czynność wykonywana przez AI wymaga modelu zdolnego napisać książkę.

Wyobraźmy sobie cyfrową firmę działającą w ten sposób
Do systemu wpływa 10 000 wiadomości od klientów.
Pierwsza warstwa to zwykły kod. Sprawdza adresy, uprawnienia, numery zamówień i wszystkie informacje, które można obsłużyć w sposób całkowicie deterministyczny.
Druga warstwa to model decyzyjny, który ocenia:
„Czy to spam?” / „Czy sprawa wygląda na pilną?” / „Czy dotyczy płatności, reklamacji czy problemu technicznego?” / „Czy mamy wystarczającą pewność, żeby obsłużyć ją automatycznie?”
Większość zgłoszeń może zostać skierowana dalej bez angażowania najpotężniejszego modelu. Dopiero sprawy nietypowe, skomplikowane lub niejednoznaczne trafiają do zaawansowanego LLM albo do człowieka.
Zamiast więc budować system, w którym AI robi wszystko, można budować system, w którym różne narzędzia wykonują dokładnie te zadania, do których najlepiej się nadają. To subtelna różnica, ale z punktu widzenia przyszłości automatyzacji może być bardzo ważna.
Gdzie taki „semantyczny if” może się przydać?
Potencjalnych zastosowań jest sporo.
Obsługa klienta
Model może analizować przychodzące zgłoszenia i określać ich temat, pilność czy właściwy dział. Proste przypadki trafiają automatycznie do odpowiedniej kolejki. Niejasne – do człowieka.
Moderacja treści
Komentarz może zostać oceniony pod kątem spamu, agresji albo zgodności z regulaminem. Zamiast generować opis tego, dlaczego treść wygląda podejrzanie, system potrzebuje czasem jedynie informacji: „Prawdopodobieństwo naruszenia: 94%”.
Inteligentne systemy firmowe
Wyobraźmy sobie system analizujący dokumenty. Nie musi streszczać każdej faktury, umowy czy wiadomości. Może najpierw odpowiedzieć: Czy ten dokument jest w ogóle istotny dla aktualnego procesu? Jeżeli nie – nie angażujemy kolejnych zasobów.
Agenci AI
To prawdopodobnie jedno z najciekawszych zastosowań. Agent wykonujący skomplikowane zadanie co chwilę musi podejmować decyzje:
- którego narzędzia użyć,
- czy wyszukać dodatkowe informacje,
- czy ponowić próbę,
- czy wynik wygląda wiarygodnie,
- czy potrzebne jest głębsze rozumowanie,
- czy powinien poprosić człowieka o pomoc.
Dziś często wszystkie te decyzje podejmuje jeden duży model. W przyszłości rolę „dyspozytora” może przejąć mniejszy i znacznie szybszy model decyzyjny.
Małe decyzje mogą też rozwiązać problem ogromnego kontekstu
Modele AI potrafią dziś pracować na bardzo dużej ilości informacji, ale „dużo” nie zawsze znaczy „dobrze”. Agent wykonujący zadanie przez długi czas może zgromadzić tysiące komunikatów, wyników wyszukiwania i odpowiedzi narzędzi. Nie wszystkie są nadal potrzebne.
Jednym z ciekawszych eksperymentów opisanych przez Sébastiena Dubois jest wykorzystanie Jev do oceniania przydatności poszczególnych elementów historii działania agenta. Zamiast generować nowe streszczenie całej rozmowy, model po prostu określa, które informacje warto zachować. W opisanym przykładzie kontekst liczący około miliona tokenów został ograniczony do około 86 tysięcy.
To trochę jak sprzątanie biurka. Nie musimy przepisywać zawartości wszystkich leżących na nim dokumentów. Czasem wystarczy zdecydować: zostawić czy wyrzucić?
Czy to oznacza koniec dużych modeli językowych?
Wręcz przeciwnie. Modele takie jak ChatGPT, Claude czy Gemini nadal są niezastąpione wszędzie tam, gdzie potrzebujemy kreatywności, tworzenia nowych treści, prowadzenia rozmowy albo złożonego rozumowania. Chodzi raczej o to, aby nie wykorzystywać ich do każdej możliwej czynności.
Można to porównać do firmy.
Nie każdą decyzję musi podejmować prezes. Część spraw rozwiązuje procedura. Część pracownik podejmujący szybką decyzję. Dopiero bardziej skomplikowane problemy trafiają wyżej. Podobna architektura może pojawić się w świecie AI:
klasyczny kod → model decyzyjny → duży model językowy → człowiek
Każda warstwa uruchamiana jest wtedy, kiedy rzeczywiście jest potrzebna.
Jest jednak kilka ważnych „ale”
Jev nie jest magicznym rozwiązaniem wszystkich problemów. Pierwsze ograniczenie jest bardzo istotne: model podejmuje decyzję, ale nie musi potrafić jej wyjaśnić. Możemy otrzymać wynik 0,87, ale niekoniecznie dowiemy się, dlaczego akurat taki. To problem wszędzie tam, gdzie uzasadnienie decyzji ma znaczenie prawne, biznesowe albo po prostu ludzkie.
Drugie ograniczenie dotyczy precyzji. Takiego modelu nie należy traktować jak kalkulatora czy systemu reguł biznesowych. Jeśli coś można policzyć albo jednoznacznie sprawdzić w klasycznym kodzie, zazwyczaj właśnie tam powinno pozostać.
Trzecia kwestia to zamknięty zestaw odpowiedzi. Jeżeli każemy modelowi wybrać pomiędzy „sprzedażą”, „księgowością” i „pomocą techniczną”, a wiadomość dotyczy rozwiązania umowy, system nadal musi jakoś poradzić sobie w ramach możliwości, które mu daliśmy. Dlatego dobra architektura powinna uwzględniać odpowiedzi w rodzaju „inne”, progi pewności i możliwość przekazania nietypowego przypadku człowiekowi.
I wreszcie – modele decyzyjne również trzeba testować. To, że odpowiedź ma postać eleganckiej liczby, nie oznacza automatycznie, że jest poprawna.
Najciekawsze w Jev może wcale nie być Jev
Wokół pomysłu niemal natychmiast zaczęły pojawiać się projekty open source próbujące budować podobną warstwę decyzyjną. SemIf, Kev czy Jevlike pokazują coś ważniejszego niż przyszłość jednego produktu. Być może rodzi się nowa kategoria narzędzi AI.
Przez ostatnie lata dominowały dwa światy. Pierwszy to tradycyjne programowanie: szybkie, tanie i przewidywalne, ale wymagające precyzyjnego opisania każdej reguły. Drugi to generatywna AI: elastyczna i świetnie radząca sobie z językiem, ale droższa i mniej przewidywalna.
Modele decyzyjne próbują znaleźć miejsce pomiędzy nimi. Nie mają zastąpić ani kodu, ani LLM-ów. Mają je połączyć.
Być może przyszłość AI będzie mniej… spektakularna
Największe zainteresowanie zwykle wzbudzają modele, które potrafią zrobić coś widowiskowego. Wygenerować film. Napisać aplikację. Stworzyć grafikę. Rozwiązać bardzo trudne zadanie.
Tymczasem ogromna część realnej cyfryzacji firm polega na czymś znacznie mniej efektownym. Podejmowaniu tysięcy drobnych decyzji. Jeżeli AI zacznie podejmować takie decyzje szybko, tanio i wystarczająco dobrze, może to mieć większe znaczenie dla codziennych systemów informatycznych niż kolejny chatbot potrafiący napisać jeszcze ładniejszy e-mail.
Jev jest dziś jednym z pierwszych eksperymentów pokazujących ten kierunek. Czy „System One Models” staną się trwałą kategorią technologii? Na odpowiedź jest jeszcze za wcześnie. Sama idea wydaje się jednak bardzo sensowna: nie używajmy największego możliwego modelu do każdego problemu. Czasem nie potrzebujemy AI, które przez kilkanaście sekund zastanawia się nad odpowiedzią. Czasem potrzebujemy po prostu inteligentnego: „jeżeli… to…”


Dodaj komentarz
Chcesz się przyłączyć do dyskusji?Feel free to contribute!